引言
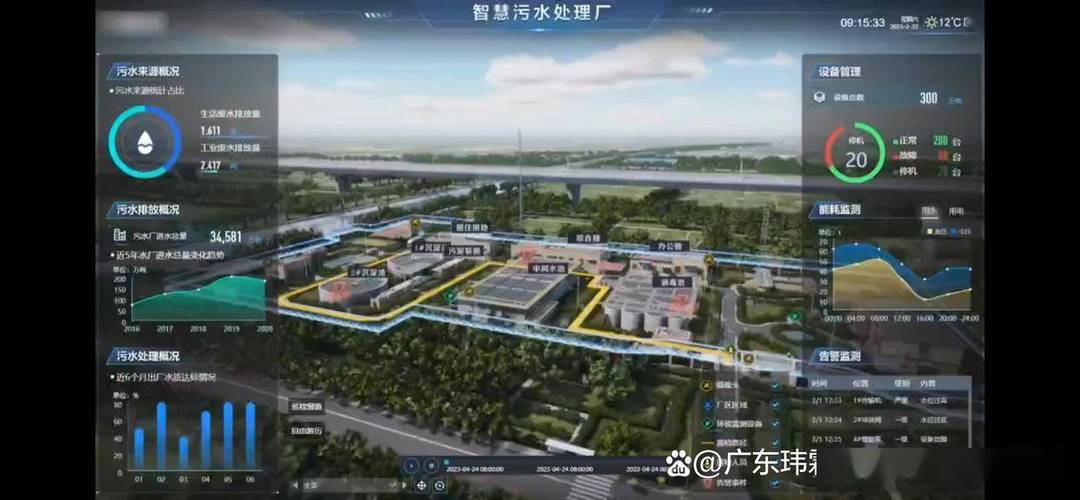
随着城市化进程加快与环保监管趋严,污水处理厂面临运营效率、能耗控制和合规排放的多重压力。数字孪生技术通过构建物理实体的虚拟镜像,实现实时监控、仿真预测与优化决策,成为智慧水务的重要方向。数字孪生的核心挑战并不在于三维可视化,而在于如何高效地采集、清洗、融合、存储和分析来自海量传感器、设备和业务系统的数据。因此,面向污水处理厂数字孪生的数据处理服务成为决定项目成败的关键基础设施。
一、数字孪生对数据处理的核心需求
1. 实时性与低延迟
污水工艺流程(如曝气、加药、污泥回流)具有连续动态特性,数据延迟会造成控制失当。数据处理服务需支持毫秒级至秒级的数据采集与流式计算。
2. 多源异构数据集成
数据来源包括:底层PLC/SCADA的时序数据、水质在线仪表(COD、氨氮、总磷、pH、溶解氧)、视频监控、巡检机器人、实验室化验数据、气象与管网数据等。这些数据在协议(Modbus、OPC UA、MQTT、HTTP)、格式和更新频率上差异巨大。
3. 数据质量与清洗
传感器漂移、缺失值、异常尖峰、通讯中断频繁出现。数据处理服务必须提供实时数据校验、缺失值插补、异常检测与滤波,否则孪生模型会失真。
4. 高吞吐与时序存储
万吨级污水处理厂每秒可能产生数万数据点,长期存储需兼顾压缩率与查询性能。
5. 模型驱动的双向交互
数字孪生不仅要接收数据,还要向物理系统反送优化指令(如设定曝气量、泵频率),并要求处理后数据可被机理模型、机器学习模型和CFD仿真调用。
二、数据处理服务的技术架构
推荐采用云边协同的分层架构,包括:
- 边缘层:在厂区部署边缘网关或轻量级数据处理节点,完成协议解析、本地过滤、边缘缓存与紧急控制。常用技术:Node-RED、Telegraf、EdgeX Foundry。
- 接入与消息层:通过MQTT、Kafka、Pulsar等消息中间件实现高并发、可持久化的数据总线,支持数据回放与多消费组。
- 流处理层:使用Flink、Spark Streaming或Kafka Streams执行实时清洗、窗口聚合、复杂事件处理(CEP)。典型任务:滑动平均平滑DO数据、检测曝气池异常波动产生告警。
- 批处理与治理层:采用Spark或Airflow进行历史数据补录、模型训练样本生成、数据血缘与质量报告。
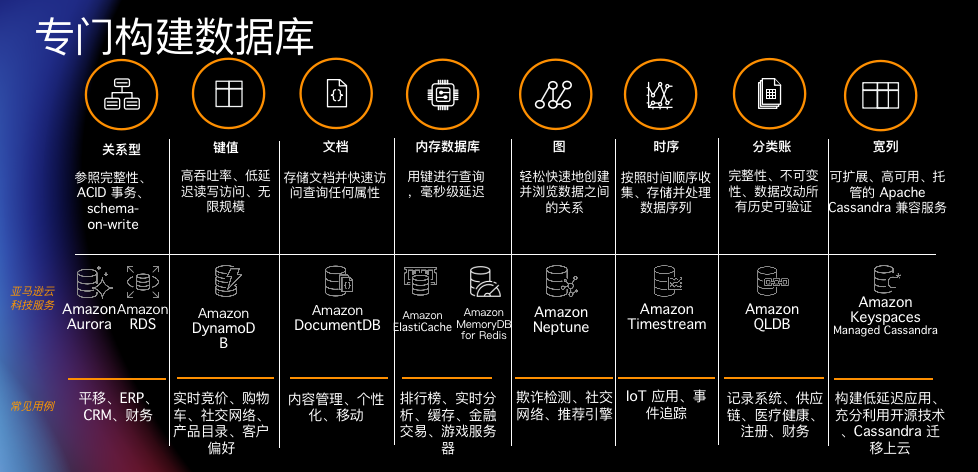
- 时序存储层:使用TDengine、InfluxDB、TimescaleDB或Apache IoTDB,按时间分区、列式压缩,支持降采样查询与LastPoint索引。
- 孪生服务层:提供统一API,将处理后数据映射到孪生模型实体(如反应池、泵组、阀门),驱动仿真引擎(如Modelica、Simulink、自定义代理模型)。
- 可视化与交互层:以3D引擎(Unity、Unreal、Cesium)呈现,集成实时曲线、报警和操作面板。
三、关键数据处理技术
3.1 实时ETL与数据映射
定义元数据模型:设备-测点-物理量-单位-量程。使用CDC(变更数据捕获)技术从SCADA历史库抽取增量数据,避免全量轮询。
3.2 异常检测与清洗
- 统计方法:3σ、箱线图、滑动MAD。
- 机理约束:水质参数间存在物料平衡关系(如COD与曝气量、污泥浓度),可做出物理一致性校验。
- 机器学习:Isolation Forest、AutoEncoder用于高维异常模式。
- 清洗策略:标记异常点不直接抛弃,供孪生系统进行置信度加权。
3.3 数据融合与对齐
- 时间对齐:不同传感器采集周期不一致,需进行NTP/PTP时间同步与重采样(如线性插值、样条插值)。
- 空间对齐:将测点映射到孪生体三维网格或工艺单元。
- 特征融合:生成综合指标如“比耗氧速率SOUR”、“营养物去除率”供模型使用。
3.4 流批一体与数据湖
利用Apache Hudi/Iceberg构建数据湖,支持流式写入与批量查询,保留原始数据与清洗过程的完整可审计性,满足环保数据留存要求。
四、典型应用场景
1. 实时工艺监控与告警
数据处理服务持续计算溶解氧、污泥容积指数等关键指标,当预测偏离设定区间时提前15-30分钟告警,避免出水超标。
2. 能耗优化仿真
读取历史与实时电量、曝气量数据,在孪生体中模拟不同策略下拉格朗日乘子,寻找鼓风机最优频率组合。
3. 设备健康管理
融合振动、温度、电流数据,结合时序异常检测算法(LSTM-AE)判断泵/风机潜在故障,输出剩余寿命预测。
4. 应急预案演练
数字孪生回放历史异常工况(如进水冲击),基于清洗后的多源数据反复推演,训练人员并优化操作规程。
五、实施挑战与建议
挑战:
- 旧厂仪表数字化程度低,数据源不稳定。
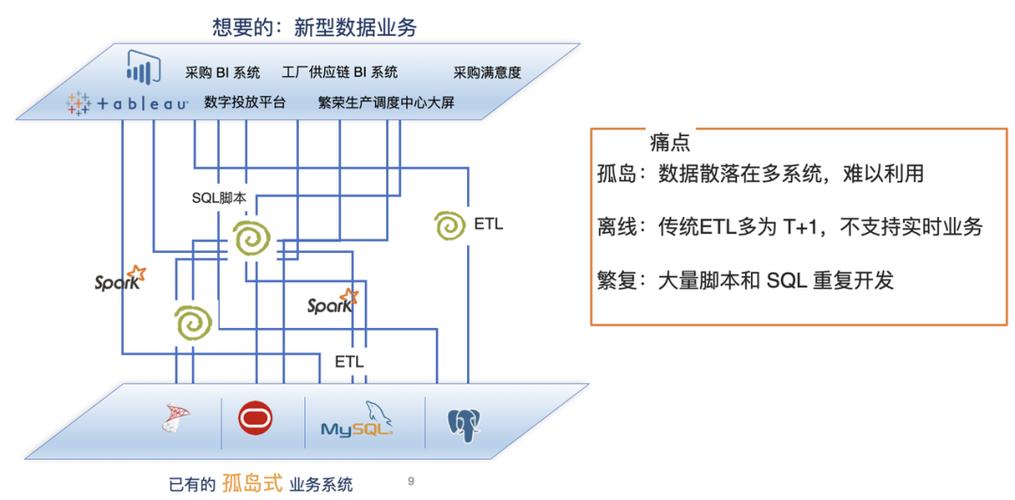
- 数据孤岛:自控、运维、化验系统互不相通。
- 模型与数据闭环周期长,需不断标定。
建议:
- 先从关键单元(曝气池)做最小可行孪生,围绕其建设数据处理流水线,快速验证价值。
- 建立统一数据编码和元数据标准,与ISO 15926或工业互联网标识体系对齐。
- 边缘预处理减少上行流量,利用规则引擎进行紧急控制。
- 组建涵盖工艺、自控、IT的复合团队,以及时校正数据处理逻辑。
##
污水处理厂数字孪生的本质是“数据驱动的工艺镜像”。数据处理服务提供了实时性、准确性和可用性的根基,使孪生体不止于可视化,而能进入工艺优化与自动控制的闭环。随着边缘AI和时序数据库的发展,面向污水处理厂的数字孪生数据处理将朝着更敏捷、更智能、更开放的方向演进,成为实现节能降碳、稳定达标排放的关键引擎。